


 App Store
 Steam
基于RL+LLM的关卡生成探索(一)
作者:余田 首发“鱼塘游戏制作工坊”公众号
一、前言
莫慌,本文古法手搓,不含复杂概念和公式,只包含论文精华和个人思考,我家猫说她勉强能看懂。
最近对LLM在游戏侧的应用陷入一些瓶颈,其中包括之前文章提到过的那些痛点:幻觉,黑盒,上下文不足,对实际内容没有感知等,总结为“不够可控”,于是想往强化学习(RL)方向看看,进行了一波文献大学习。
而且我最近有个感觉,大家都在疯狂拿AI做产出(包括我),用自己的专家知识和判断,驱动AI不停前进,反过来说,AI像是在不停汲取使用者,人好像变成了AI的燃料(多开的前额叶撕裂者们肯定知道我在说什么)。所以也想系统学习一波,充充能,目的不是做研究,而是汲取一波新上下文 ,看看有没有启发,不管是对游戏开发还是AI应用。
于是进行了一波基于业务和兴趣的大学习,由于这个领域细分太多了,有目的性的学习效率更高,所以先聚焦到关卡生成这个领域,具体理由可以参考之前AI原生游戏的文章。
同时,充分利用AI,我先开发了一个论文阅读助手,一个带术语速查,论文分类管理,关联论文关系等功能的妙妙小工具,大大提高阅读效率。反正是学的过程中,哪里不舒服,都让AI加功能,AI时代学习效率真的提升好多。我不禁有一种感慨:
当前时代,有一个被AI应用效率提升掩盖的巨大财富,就是AI带来的学习能力提升。
虽说是往RL方向看,但实际当前主流都是混合系统,纯RL思路走向AGI的路线主要是sutton和sliver他们在搞,还挺吸引人的。但不重要,我们还是专注于游戏开发,怎么对做游戏有用怎么来。目前读了80+论文,其中有一些我觉得有帮助的,直接贴目录:
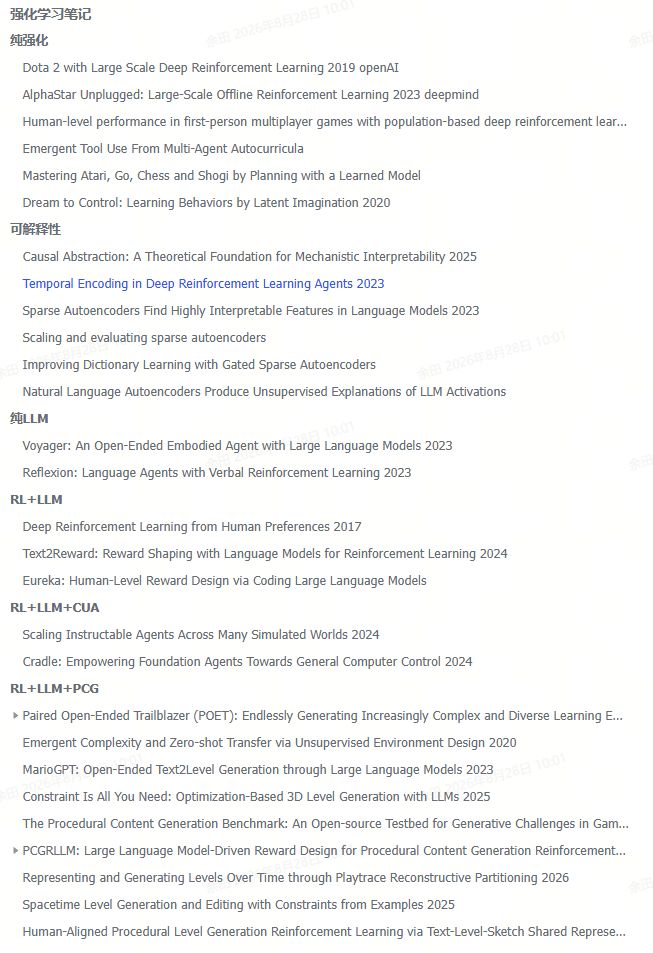
这些论文各领域都有,主要可以分为两大类,第一部分是和RL相关+游戏相关的经典论文,用于了解背景知识,对研究历程有个感知,这部分只提取对游戏开发有启发的精华。第二部分是直接跟关卡生成或PCG相关的论文。
这些论文每篇都很长,笔记也很长,本文先进行一部分论文笔记的精华提取,以及个人思考的分享,不会对原文照本宣科,也不涉及复杂的概念,争取用最直白,最不绕弯子的文字稳稳地接住你。
二、论文启发(第一波)
Dota 2 with Large Scale Deep Reinforcement Learning 2019
OpenAI这篇可谓是RL领域的圣经之一了,简而言之,就是OpenAI 19年开发了一个强化学习系统OpenAI Five,用来挑战dota2,经过训练后,2比0击败了世界冠军队伍OG,并且在随后的公开赛中,对普通玩家胜率99.4%。dota2的复杂程度不用多说,非常牛逼。这篇论文有几个我觉得有意思的点:
作者强调,如果要在真实游戏中训练强 AI,工程大于算法。OpenAI Five用的PPO、GAE、LSTM 都不是全新算法,真正困难的是把环境、观测、动作、奖励、分布式训练、版本管理和评估闭环接起来并让它稳定运行 10 个月。工程基础设施比任何单个算法都重要。
训练过程包含大量设计,例如奖励设计,只有胜负这个奖励过于稀疏,他们尝试了,也能训,但是学习速度巨慢。而加入过程奖励设计,包括击杀,补刀,推塔,获得经验,team spirit(促进团队合作用的)等等,效果质变。但他们也承认,整套奖励设计没有怎么大改过,并不是最优的,突出一个够用。这给我的启发是,游戏设计在训练过程中其实能够发挥非常大的作用,好的设计,能够大大提高训练速度,甚至有时候是可行与否的区别。
自博弈能产生超人策略。它可以超越模仿,发现人类不常用但有效的打法。其中超越人类的有个特征我觉得比较有意思,AI会更愿意消耗资源和长冷却技能,而人类常把这些能力留给“后续也许更好的机会”,这太典了!另外,自博弈不能只跟紧邻的上一版进行对战,否则可能会出现循环克制,导致策略收敛,需要引入历史版本。这点后续自己设计AI评估对战的时候也要注意。
过程中评估策略用了TrueSkill,之前写了文章专门介绍过这个。这篇论文是第一篇看的,所以很多RL的术语都得学,一堆陌生术语里突然冒出一个自己熟悉的,有点感动怎么回事!
AlphaStar Unplugged: Large-Scale Offline Reinforcement Learning 2019
这篇也是经典,是deepmind针对星际争霸2做的强化学习系统,并且是离线强化学习系统,离线是指不给智能体边玩边学,而是只能看人类录像来学。例如上面dota2的就是在线强化学习。这篇论文我最有启发的点是:
如何防止AI训练出来的某个策略被针对,AlphaStar的做法是把目标从战胜自己(自博弈),改为尽量战胜一个集合内的所有对手,然后对这个集合内的对手也进行优化,优化目标是不被某个对手全部击败,这样做对抗训练,一起提升。
这对游戏AI的开发有启发,后续开发对策AI,可以做一个新的标准,就是是否能战胜一个集合的目标,来衡量AI的鲁棒性,这在博弈类策略AI里面非常之关键,因为一个策略强弱与否,不单纯是胜率这么简单,是否容易被反制,被反制后的体验如何,这些隐性指标,之前没有被很好量化。另外PVP游戏中,反过来利用,可以用于防止策略收敛,我们要保证每一个策略,不能战胜集合中的所有对手,并且要保持一个合适的比例。
Emergent Tool Use From Multi-Agent Autocurricula 2020
这篇是OpenAI主导的一个研究,他们搞了一个物理模拟的捉迷藏游戏,让两队智能体自己在里面对抗,一方抓一方躲,训练奖励极简,只有被看到-1,藏好+1这样。环境里有各种工具,比如箱子,斜坡等,但完全不管智能体用不用,只有最终奖励,和两方不停竞争。然后经过大量对局,智能体自发涌现了各种策略,并且是跟人一样的策略军备竞赛,我用更好的策略克制你,你再针对提升策略克制我,如此循环,双方不断变强。这其实就是论文的核心概念:多智能体竞争的自生成训练课程(autocurriculum)。
这个策略军备竞赛过程比较有趣,大体分六个阶段:
双方单纯的追和逃
躲藏者们开始用箱子围住自己,让追逐者进不来,看不到自己
追逐者搬来斜坡攻入箱子堡垒
躲藏者锁住斜坡,不让追逐者用
追逐者利用物理漏洞,踩着箱子滑行
躲藏者锁住箱子
其中比较有意义的是,追逐者涌现了预期之外的物理漏洞利用,并且从实验的角度佐证了我们设计中常用的方法:简单机制+物理就足够涌现出复杂的结果。规则越简单清晰,交互可能性越多,越容易产生涌现的惊喜。
这篇的核心思路其实和前面几篇互相关联,智能体的互相对抗是一种高效的提供挑战压力,促进策略进化的手段,同时可以省去很多过程中的奖励函数设计,奖励设计一直是RL的大痛点,本质上我认为是因为奖励设计本身就代表了设计者对这件事的理解,本质上也是专家知识介入,因此,受限于人类的上限,很难尽善尽美,并且也会限制智能体的上限,只能是一种辅助,一种捷径。
但对于游戏来说,稍有不同,反而是可以吸收自迭代的精华后,更多的用专家知识来控制体验,毕竟游戏的目标不是进化而是体验,就如以前的文章所说,对设计来说,可控涌现才是好涌现。
Human-level performance in first-person multiplayer games with population-based deep reinforcement learning 2018
这篇是多智能体强化学习领域的里程碑成果,专门针对FPS游戏《雷神之锤3:竞技场》的夺旗(CTF)模式进行训练。牛逼的点在于,AI仅以低分辨率的游戏像素画面和游戏得分作为输入,没有为AI行为编写任何人工预设的硬编码规则,训练全程不告诉AI游戏玩法,仅通过最终的胜负结果作为反馈。最终训练完可以对人类胜率达到70%,还能跟人类组队协作。
本篇论文最震撼我的一点是对智能体内部神经网络可解释性的研究,简单来说,作者用一些方法,将智能体的神经元的隐藏状态,转为一张可视化的二维图形,观察到了明显的表征行为,就是对特定场景有规律的激活特定神经元,甚至出现了类似人类“概念神经元”的表现,例如,当智能体的旗帜被夺走时或智能体的队友夺到旗帜时,某个神经元就会被激活。
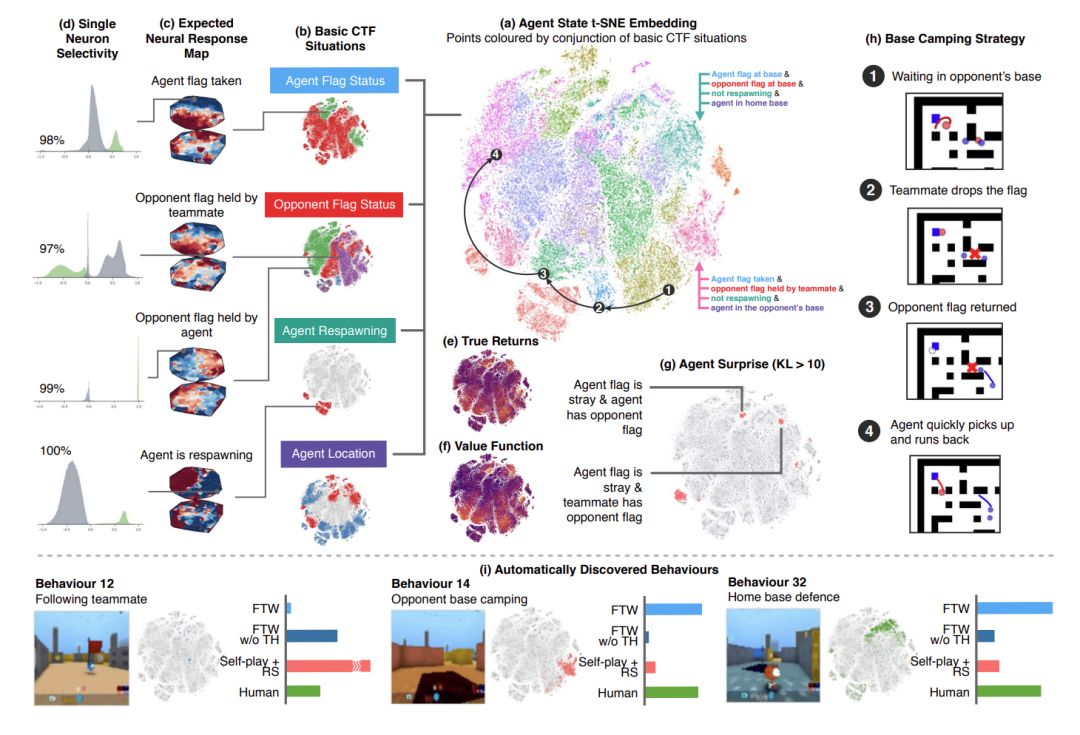
这真是非常之酷,可解释性正是我当前遇到的最大痛点之一,另外,这个痛点同样横跨神经科学,AI研究,AI应用,复杂系统等领域存在,个人认为,可解释性的研究,是这些领域往上突破且可控的正路。用一句话来说就是:从炼金术变成化学。
Sparse Autoencoders Find Highly Interpretable Features in Language Models 2023
当然,上一篇说的单个神经元相关的,是有局限的。实际的人类神经元和大模型,都是单个神经元会对多个不相关的概念激活,例如同一个神经元既对中国有反应,又对猫有反应,还对冰淇淋有反应。这就是多义性。本质是在能量和空间限制下,有限的大脑认知无限世界,必须要做的压缩,同时,这本身也是是一种高效的做法,大模型也一样如此。这个就是叠加态假设(Superposition Hypothesis)。但这就对可解释性带来了麻烦,就算观察到激活了某个神经元,也不确定它具体代表什么。
本篇的SAE(稀疏自编码器)就是来解决这个问题的。SAE是一个用来搞清楚目标模型在想什么的外挂小模型。我用一个最好理解的例子来解释一下SAE的原理:
第一步,先收集原材料,让原模型读海量文本,在它疯狂运转时,把它内部那些混乱的神经元激活信号数据全部记录下来。
第二步,在原模型外面挂载一个独立的 SAE 小模型。SAE 拥有比原模型多十倍甚至百倍的神经元,并在训练中被死死卡住一个变态规则:“每次只准用最少数最精准的神经元,来还原原始模型的信号”。然后SAE 经过数亿次迭代,逼迫自己用一个神经元代表一个概念,例如42号神经元,只代表某个概念X,在这三句话出现的时候激活。
第三步,自动化贴标签(用AI理解AI):这时候还不知道42号神经元具体概念X对应是什么,于是,就把这三句话扔给另一个“AI考官(大模型)”去自动分析和总结这些句子的共同点。例如这三句话是:
我有一只猫
有个东西在喵喵叫
大脸猫大脸猫爱吃鱼
经过对比总结,预测,验证等手段,定下42号神经元对应概念是“猫”。其他神经元也同理。
这就是为什么SAE需要比原模型多很多倍的神经元,本质上有点像把原模型高度压缩的概念解压出来,变成一个个单独的概念,自然就好理解了,可解释了。
这里面最重要的一点就是怎么让SAE用最少数的神经元还原原始信号,本论文是最初的L1方法,简单来说就是罚款,SAE训练时每次还原用的神经元越多,信号越强,就罚款越多。这样训出来的虽然能达成目的,但有几个问题:
由于会罚信号强度,即使是正确的神经元,也会倾向把信号强度搞低点,由于强度本身是有意义的,比如非常非常快乐,会被降级成开心,以减少惩罚,因此这里会造成失真,也就是强度收缩(Shrinkage)。
由于会罚数量,因此会有很多本身应该参与表达的神经元,一直不被用到,就会导致这些神经元后续也唤醒不了,这就是死特征(Dead Features)。
虽然惩罚了数量和强度,但实际每个输入到底激活几个神经元,强度如何是不确定的,同时,调参会很敏感,调严格了,压缩过头直接崩坏,调宽松了没意义,而且不同输入,不同规模,情况都会变(全部是单词和全部是长句子的输入,明显惩罚程度需要不一样),所以调参非常麻烦。
Scaling and evaluating sparse autoencoders 2024
这篇就是后续提出的更先进的TopK SAE方法,简单来说,就是不用惩罚的方式训练,而是不管输入是什么,直接指定K个信号最强的神经元。也就是指定你用K个词来描述原始输入。这个方式好处如下:
完全不惩罚每个选中词的强度,因此没有L1方法的强度收缩问题。
模型被迫在每步选 K 个神经元,即使某些神经元不常用,模型也会“翻出来用一用”,大幅减少死特征问题。
只有一个K需要调,而且K不随输入变化,也就是稀疏度一直不变,可以做很多优化,适合大规模计算,适合规模化。
当然也很容易想到,K固定的问题就是不灵活,简单的输入可能浪费,复杂的输入可能不够,后续会有其他更新的方法来优化。
Improving Dictionary Learning with Gated Sparse Autoencoders 2024
这是另一条优化L1方法的路线,也就是gate SAE,原理简单来说就是直接训两个子网络,一个gate网络专门决定要哪些神经元;另一个幅度网络决定每个神经元的强度,两者解耦。好处如下:
两者解耦,互不影响,因此幅度网络完全不会为了压数量而损失强度,彻底解决强度收缩问题。
gate网络自适应数量,不是固定值K,更符合具体输入的需求。
gate网络不会受强度影响,自由选择神经元,也大大减少死特征。
一般情况下,Gate SAE的结果会比topk好,但不是完全上位替代,因为gate复杂度明显要比topk高很多,参数量至少翻倍,并且固定稀疏度K,在很多训练场景下是刚需,因此两种路线算各有优劣。
后续25 26年主流的方法,都是对TopK SAE和gate SAE的改进,大体上的路径
自适应K值,由数据决定
从解释模型到操控模型
从单模态到多模态,从文字到视觉
彻底解决死特征问题
降低大规模训练成本
本质都是基于前面SAE的基本概念,篇幅有限,就先不展开了。
Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations 2026
这篇是A畜在今年五月提出的另一条道路,用自然语言来直接解释模型,原理也很简单,由两个系统组成,
1激活语义化器 (Activation Verbalizer, AV):输入模型某层的激活神经元,输出一段自然语言文本,描述它们可能代表什么。
2激活重建器 (Activation Reconstructor, AR):输入 AV 生成的文本描述,尝试重建出原始的激活神经元。
两个系统通过强化学习(RL) 进行联合训练,目标是最小化原始激活与 AR 重建激活之间的误差。
这个方式的核心优势就是产出是直接的自然语言,人类直接能看懂,并且能描述高层次的认知、推理、怀疑或意图等复杂概念。缺陷就是不像SAE那么精确,并且也会出现幻觉,实验里出现过编造的情况。
NLA和SAE方法不是对立的,各有优劣,两者可以结合起来,有研究者将SAE产出的特征,用NLA来解释,利用了两者的优势,不失为一个好的路子。
三、总结
5k字了,写不完,根本写不完!看一篇,又延伸出好多篇,学不完,根本学不完!感觉大脑褶皱都要学展开了,写作时间有限,本篇先起个头,以强化基础+可解释性这条脉络进行引入,剩下估计还有好多篇,结合实践,慢慢输出吧。
为学日益,为道日损,共勉。
评论
登录 后参与讨论
暂无评论,来抢沙发




 闽公网安备 35020302034348号